서브쿼리는 쿼리 안에 또다른 쿼리가 있다는 뜻으로, 가져온 데이터를 재정제하기 위해 사용한다.
y = x+1
z + y = 6
두 번째 식에서 y 자리에는 x+1을 넣을 수 있는데, 서브 쿼리도 유사한 방식으로 사용된다고 보면 된다.
우선 테이블은 선언한 뒤 제약조건을 만들어보자.
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
|
create table dept(
deptname varchar(50)
,loc varchar(10)
,deptno varchar(10)
);
create table emp(
ename varchar(50)
,job varchar(50)
,hiredate date
);
-- dept의 deptno 컬럼을 기본키 지정
alter table dept add constraint primary key(deptno);
-- emp에 컬럼 추가
alter table emp add(deptno varchar(10));
-- emp에 외래키 지정
alter table emp add constraint foreign key(deptno) references dept(deptno);
-- 제대로 지정됐나 제약조건 확인
select * from information_schema.TABLE_CONSTRAINTS tc where TABLE_NAME = 'emp';
|
cs |
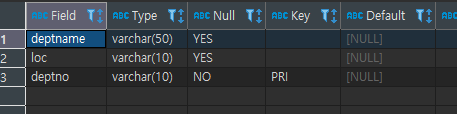
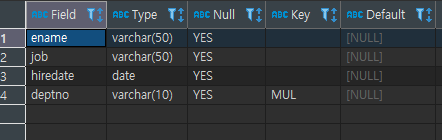
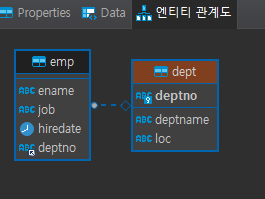
테이블은 정상적으로 만들어졌으니, 이제 데이터를 넣어준다.
|
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
|
-- dept에 데이터 삽입
select * from dept;
insert into dept(deptno,deptname,loc) values (1,'sales','NEWYORK');
insert into dept(deptno,deptname,loc) values (2,'dev01','LA');
insert into dept(deptno,deptname,loc) values (3,'personnel','NEWYORK');
insert into dept(deptno,deptname,loc) values (4,'delevery','BOSTON');
-- emp에 데이터 삽입
select * from emp e;
insert into emp(ename,job,deptno,hiredate) values('kim','manager',1,str_to_date('16/01/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('lee','staff',1,str_to_date('15/01/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('han','staff',1,str_to_date('16/03/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('kim','assistant',1,str_to_date('15/08/12','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('ahn','staff',2,str_to_date('15/11/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('hwang','manager',2,str_to_date('15/08/12','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('cha','assistant',2,str_to_date('12/03/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('hong','staff',2,str_to_date('14/08/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('gang','staff',2,str_to_date('16/01/02','%Y/%m/%d'));
insert into emp(ename,job,deptno,hiredate) values('nam','leader',4,str_to_date('10/01/02','%Y/%m/%d'));
|
cs |
이제 넣어준 데이터를 기반으로, 서브쿼리를 이용하여 원하는 데이터를 뽑을 것이다.
먼저 han의 근무부서(deptname)을 찾아보겠다.
|
1
2
3
4
|
-- 1. emp 테이블에서 han의 deptno를 찾고,
select deptno from emp where ename = 'han';
-- 2. dept 테이블의 deptno 컬럼의 값이 1일 때 deptname이 무엇인지 알아낸다.
select deptname from dept where deptno = 1;
|
cs |
서브쿼리를 이용하지 않을 경우에는 쿼리문을 두 가지로 작성해서 값을 찾아야한다.
하지만 서브쿼리를 이용하면
|
1
|
select deptname from dept where deptno = (select deptno from emp where ename = 'han');
|
cs |
두 쿼리문을 하나로 합칠 수 있다.
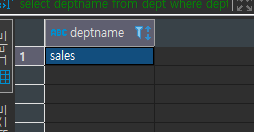
두 경우 모두 동일하게 sales 값을 도출할 수 있다.
서브쿼리는 단순히 두 쿼리문을 합치는것 뿐만이 아닌 쿼리를 컬럼처럼 사용하게끔 할 수도 있다.
예를 들어, 부서별로 직원이 몇 명인지 나타보겠다(부서명, 부서 위치, 부서 인원수를 불러올 것이다).
우선 부서별 직원과, 각 부서의 이름과 위치를 찾아볼 것이다.
|
1
2
3
4
5
6
7
8
9
10
11
|
-- 1. 부서별 직원 알아보기
-- conunt(컬럼명)은 컬럼의 수를 세어준다.
select deptno from emp e group by deptno;
select count(ename) from emp where deptno = 1; -- 4명
select count(ename) from emp where deptno = 2; -- 5명
select count(ename) from emp where deptno = 4; -- 1명
-- 2. 각 부서의 이름과 위치
select deptname,loc from dept d where deptno = 1;
select deptname,loc from dept d where deptno = 2;
select deptname,loc from dept d where deptno = 4;
|
cs |
count()로 계산한 ename들, deptname, loc을 한꺼번에 출력할 것이기 때문에, ename을 계산한 쿼리문을 컬럼처럼 사용할 것이다. 이처럼 하나의 쿼리에서 나온 내용을 다른 쿼리의 컬럼으로 사용하는 것을 상하 관계 쿼리라고 한다.
|
1
2
3
4
5
|
select
deptname
,loc
,(select count(ename) from emp where deptno = d.deptno) as cnt -- 서브쿼리를 컬럼으로 사용
from dept d;
|
cs |
이때 결과를 확인하면
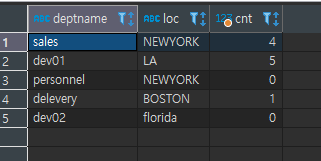
부서별 인원수가 정상적으로 뜬다.


